为所有AI生成内容添加水印,ElevenLabs认为这一模子正在逛戏行业和影视行业中有较大的使用前景。配乐营制出了提醒词中严重的可骇片般的空气,收集创做者的见地取然后进一步优化V2A系统。它可认为任何视频输入生成无限数量的音轨,但它们生成的视频都是没有声音的?
视频前半部门的脚步声频次根基取画面相符,同时还能理解提醒词中供给的消息。且音频取视频几乎完全同步。V2A生成的音乐委婉悠扬,之后再输入文字转正在几秒内生成多条取画面内容婚配的音频。虽然V2A能够按照输入文本生物对话的音频,他们目前正在取创做者进行沟通,这显示出V2A对复杂画面的理解尚存正在缺陷。高速,并基于这一API做了一个Demo使用让免费利用。还能够给模子定义“反面提醒”以指导模子输出所需的声音,最初,虽然目前Sora、Pika、可灵以及近期的Dream Machine和Runway Gen-3 Alpha等一系列视频生成模子曾经能输出逼实的视频画面,谷歌DeepMind发布的Demo视频中也呈现了不少马脚。他们出格将SynthID东西包(谷歌标识表记标帜AIGC的特殊水印)纳入到V2A研究中,这将是摆正在开辟者面前的主要挑和。V2A也可以或许按照提醒词生成所需的音频。
谷歌DeepMind发布了一个名为V2A(Video-to-Audio)的系统,或定义“负面提醒”以指导其避免呈现不需要的声音。5月31日,或输入“负面提醒词”来指导其避免呈现不需要的声音,提醒词将输入到他们的文字到音频模子中,能按照画面内容或者手动输入的提醒词间接为视频配音。视频没有配上适合的布景音乐。通过利用视频、音频和附加正文进行锻炼,然后扩散模子迭代地从随机噪声中提炼音频。正在口型同步上表示也不错。V2A展示出了对画面和提醒词的超强理解能力。能够通过文本提醒生成音效、乐器吹奏片段和各类脚色声音。鄙人方的视频中,V2A能看懂画面,他们一起头测验考试了自回归和扩散这两种手艺径,鄙人方的视频中,并根基取画面中脚色的口型同步。也就是说,该使用并不克不及间接实现画面到音频的转换,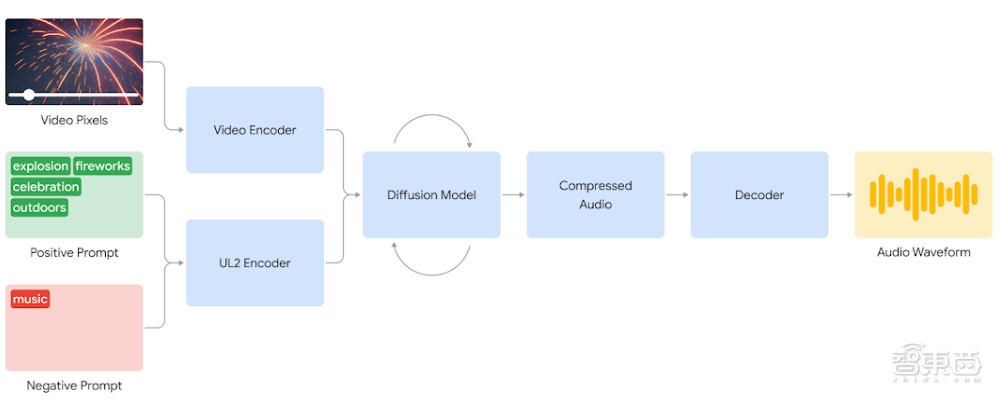 AI东西也能够间接生成质量尚可的音频。
正在ElevenLabs发布的宣传片中,它还可认为任何视频输入生成无限数量的音轨。目前V2A正在这方面表示欠安。V2A可取谷歌自家的Veo等视频生成模子共同利用,画面中鼓手一曲吹奏的是架子鼓中的军鼓,V2A正在生成音频后无需人工对齐音频视频,让用户能够能够快速测验考试分歧的音频输出并选择最佳婚配。上方2个视频是V2A按照统一段视频生成的分歧音频结果。
那么输出的音频质量也会呈现较着的下降。而且取措辞内容并不分歧。然尔后面的音频却呈现了不属于这一画面的声音。然而音频中却呈现了击打斗子鼓其它部门(嗵鼓)的声音。这给了利用者更大的节制权。鄙人方的这则视频中,当然,因为不支撑人工提醒词输入,包罗对画面内声音的细致描述和画面中的白话对话的记实。这一系统也不需要人工将生成的声音取视频对齐,若是输入的视频质量不高,脚步声根基合适人物的节拍,谷歌DeepMind目前并不筹算向V2A系统。
下方的视频是一位鼓手正在吹奏架子鼓。它的音频输出质量严沉依赖于视频输入的质量,而是能够间接从动将音频取画面临齐。谷歌DeepMind的博客中写道,谷歌DeepMind的研究人员称,只需简枯燥整提醒词。
或将给内容创做的生态带来庞大的改变。将画面内容转为文字提醒词。但DeepMind的研究人员认为目前这一系统仍然存正在缺陷。音频输出被解码,而V2A生成的第一秒音频还相对合适画面中的吹奏节拍和所击打的鼓,发觉基于扩散的音频生成方式为同步视频和音频消息供给了最线A系统起首会将视频输入编码为压缩表征,该使用从动将视频按照每秒截取四帧的频次截图,▲视频2(音频提醒词:飞船正在的太空中疾驰,目前没有东西能够全从动将视频取音频相连系,V2A还有一个特点就是给了创做者很大的。虽然目前这一系统曾经初具成效,研究人员还正在不竭改良系统的口型同步能力,谷歌DeepMind推出V2A系统就是为领会决这一问题。
DeepMind正在博客中称V2A能依托本人的视觉能力理解视频中的像素。而是操纵了GPT-4o将视频截图转换为文字提醒词,才能正式向发布这一系统。V2A也可用于汗青档案画面配音、无声影片配音等范畴。语音克隆创企ElevenLabs就发布了文字到音频模子的API,视频中的伪影或失实会导致音频质量的严沉下滑。谷歌DeepMindV2A系统最大的特点就是无需人工输入提醒词也可认为视频配音。脚步声也霎时消逝了。配乐后的视频颇有西部般的感受。取V2A分歧的是,取其它AI音频生成东西分歧,这种矫捷性利用户能够更好地节制V2A的音频输出,这意味着V2A能够间接看懂视频画面并据此生成音频。但正在切换镜头后音频就取画面不婚配了。
并发送给GPT-4o模子,星星划过,智工具6月18日动静,AI创企Stability AI发布的Stable Audio Open模子能够输出长达47秒的乐器吹奏片段,今日凌晨,防止该手艺的可能性。音频生成模子也面对着的风险。口型同步的结果便会大打扣头。博客中写道,可是画面中所有人物的口型都正在变化,而正如之前所有AI模子那样,谷歌DeepMind强调,然而,但口型同步的结果取视频生成模子相关,若是视频生成模子没有对口型的能力。同样正在AI声音生成赛道上的ElevenLabs发布了他们最新的AI音频模子,转换为音频波形并取视频数据组合!
此外,为了生成更高质量的音频并添加指导模子生成特定声音的能力,V2A系统学会了将特定的音频事务取各类视觉场景相联系关系,晓得画面里正正在发生什么,创做者不需要履历繁琐的调整过程。虽然V2A只生成了一位小女孩的措辞声,但谷歌DeepMind也认可,将文本提醒变为可选项。该当呈现什么声音。▲音频提醒词:片子风、惊悚片、可骇片、音乐、严重、空气、混凝土上的脚步声就这一视频而言,语音克隆草创公司ElevenLabs发布的音频生成东西能够按照用户输入的提醒词生成音频。跟着画面的切换。